AI-платформа
tm.hub
AI-платформа для автоматизации бизнес-задач: модули решают конкретную задачу на документах и данных компании
Сначала задача. Потом AI
- Роль
- Платформа с нуля: архитектура, движок, кабинет, инфраструктура, запуск
- Период
- Август 2026, продолжается
- Команда
- Самостоятельно + AI
- Статус
- В продакшене, идёт развитие модулей
- Ссылка
- ai-tm.ru
Как это работает
01Выбор модуля
Каталог по направлениям: проектирование, стройка, закупки, маркетплейсы.
02Загрузка
Модуль знает, какие документы ему нужны, и проверяет их до запуска.
03Проверка
Разбор, сопоставление и прогон правил — минуты вместо часов вычитки.
04Ведомость
Находки по важности и сумме, у каждой — файл, страница и строка.
05Отметки
Заказчик помечает спорное — отметки идут в настройку правил.
Что это
tm.hub — платформа, на которой собираются модули под конкретные рабочие задачи: проверка задания на проектирование, сверка актов со сметой, разбор отчёта маркетплейса, контур по входящей почте.
Общее у модулей — не тема, а устройство: личный кабинет, изоляция данных клиента, один документный движок и один формат результата. Новый модуль описывается конфигурацией, а не программируется заново.
Проблема
Расхождения в комплекте документов ищут глазами. Инженер сверяет акт со сметой построчно, снабженец сравнивает предложения поставщиков, проектировщик вычитывает задание на полноту. Работа механическая, внимание кончается раньше документа.
Проверка нейросетью эту задачу не закрывает: ответ выглядит убедительно, но при повторном запуске может отличаться, а предъявить его контрагенту нельзя — непонятно, откуда взялась цифра.
Как устроено решение
Движок один на все модули: приём файлов, нормализация, извлечение полей по схеме, операция, отчёт. Каждый шаг сохраняет результат, поэтому упавшая задача перезапускается с места сбоя, а не с начала.
Модуль — это конфигурация: какие документы принимаются, как сопоставляются строки, какие правила проверяются, что попадает в отчёт. Кода на конкретный модуль нет. Если он потребовался, значит нарушен контракт, и это повод разбираться, а не обходить.
Где здесь AI, а где нет
Правила считает обычный код. Одинаковый комплект документов даёт одинаковый результат сегодня и через год — иначе отчёт нельзя предъявить в споре. В нём нет процентов уверенности: либо расхождение есть и вот источник, либо строки в отчёте нет.
Модель подключается там, где структуры нет — сканы, свободные формулировки. Она извлекает поля, но не выносит суждение. Разделение сделано сознательно: чем меньше модели в конвейере, тем ниже себестоимость, стабильнее результат и проще развернуть систему в закрытом контуре заказчика.
Данные клиента
Главное возражение при проверке документов — куда уходит содержимое. Изоляция клиентов сделана на уровне базы, а не в коде приложения: запрос физически не может увидеть чужие строки.
Срок хранения файлов выбирает клиент — до удаления сразу после отчёта. Это механика с фоновой уборкой, а не строчка в оферте. Для тех, кому регламент не позволяет облако, та же система разворачивается в их контуре: кодовая база одна, переезд не требует переписывания.
Как это работает
01Выбор модуля
Каталог по направлениям: проектирование, стройка, закупки, маркетплейсы.
02Загрузка
Модуль знает, какие документы ему нужны, и проверяет их до запуска.
03Проверка
Разбор, сопоставление и прогон правил — минуты вместо часов вычитки.
04Ведомость
Находки по важности и сумме, у каждой — файл, страница и строка.
05Отметки
Заказчик помечает спорное — отметки идут в настройку правил.
06Выгрузка
xlsx на три листа: сводка, расхождения, отметки.
Что уже работает
- Модуль как конфигурация
- Новое направление — набор правил в JSON, а не отдельная программа.
- Сверка между документами
- Противоречия, которые в каждом документе по отдельности не видны.
- Источник у каждой находки
- Файл, страница и строка в обоих документах — проверяется за минуту.
- Перезапуск с места сбоя
- Результат каждого шага сохраняется, повторное извлечение не оплачивается дважды.
- Режим хранения на выбор
- До удаления файлов сразу после отчёта, с фоновой уборкой.
- Изоляция на уровне базы
- Не в коде приложения: чужие строки недоступны физически.
- Облако или закрытый контур
- Одна кодовая база, переезд без переписывания.
Интерфейс
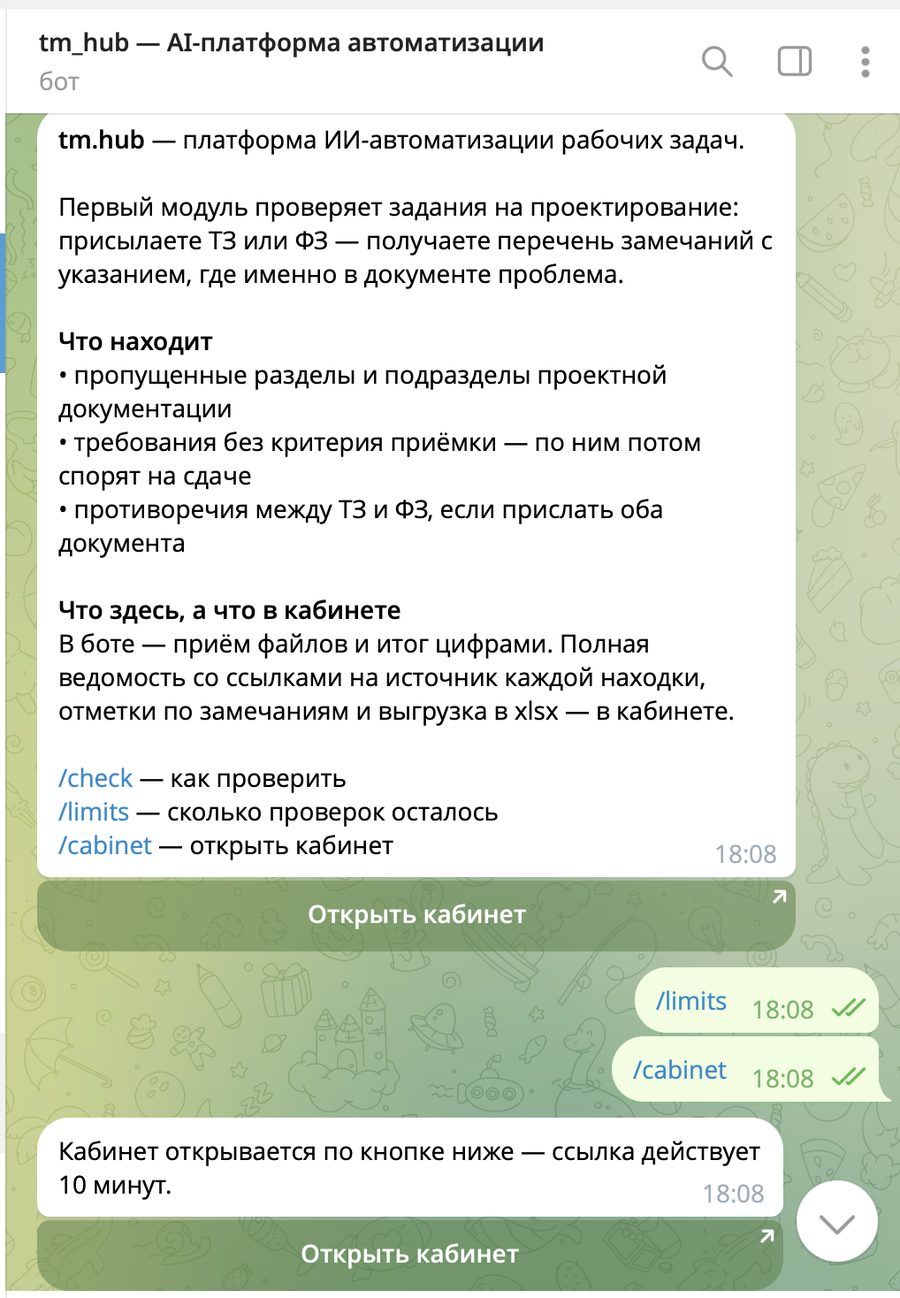
Проверка в Telegram
Файл присылается прямо в бот, итог приходит цифрами. Полная ведомость со ссылками на источник и выгрузка — в кабинете.
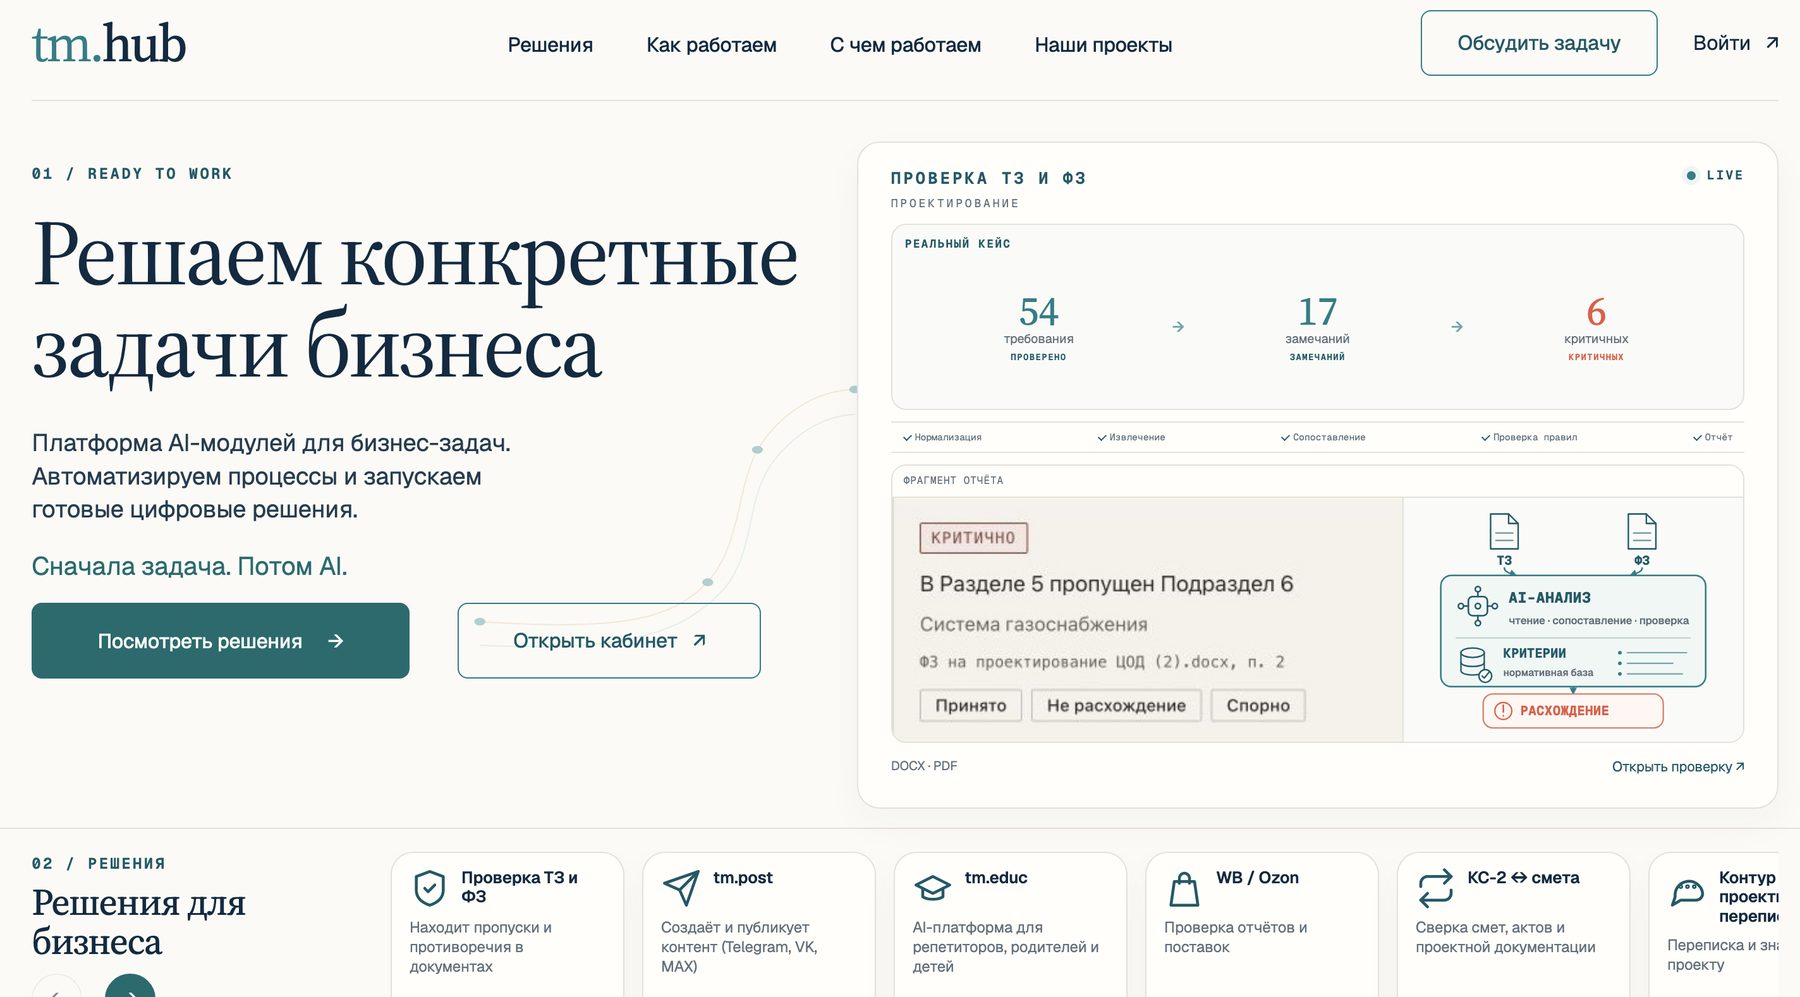
Первый экран
Реальная проверка вынесена на витрину: 54 требования, 17 замечаний, 6 критичных — и фрагмент отчёта с указанием, где именно в документе проблема.
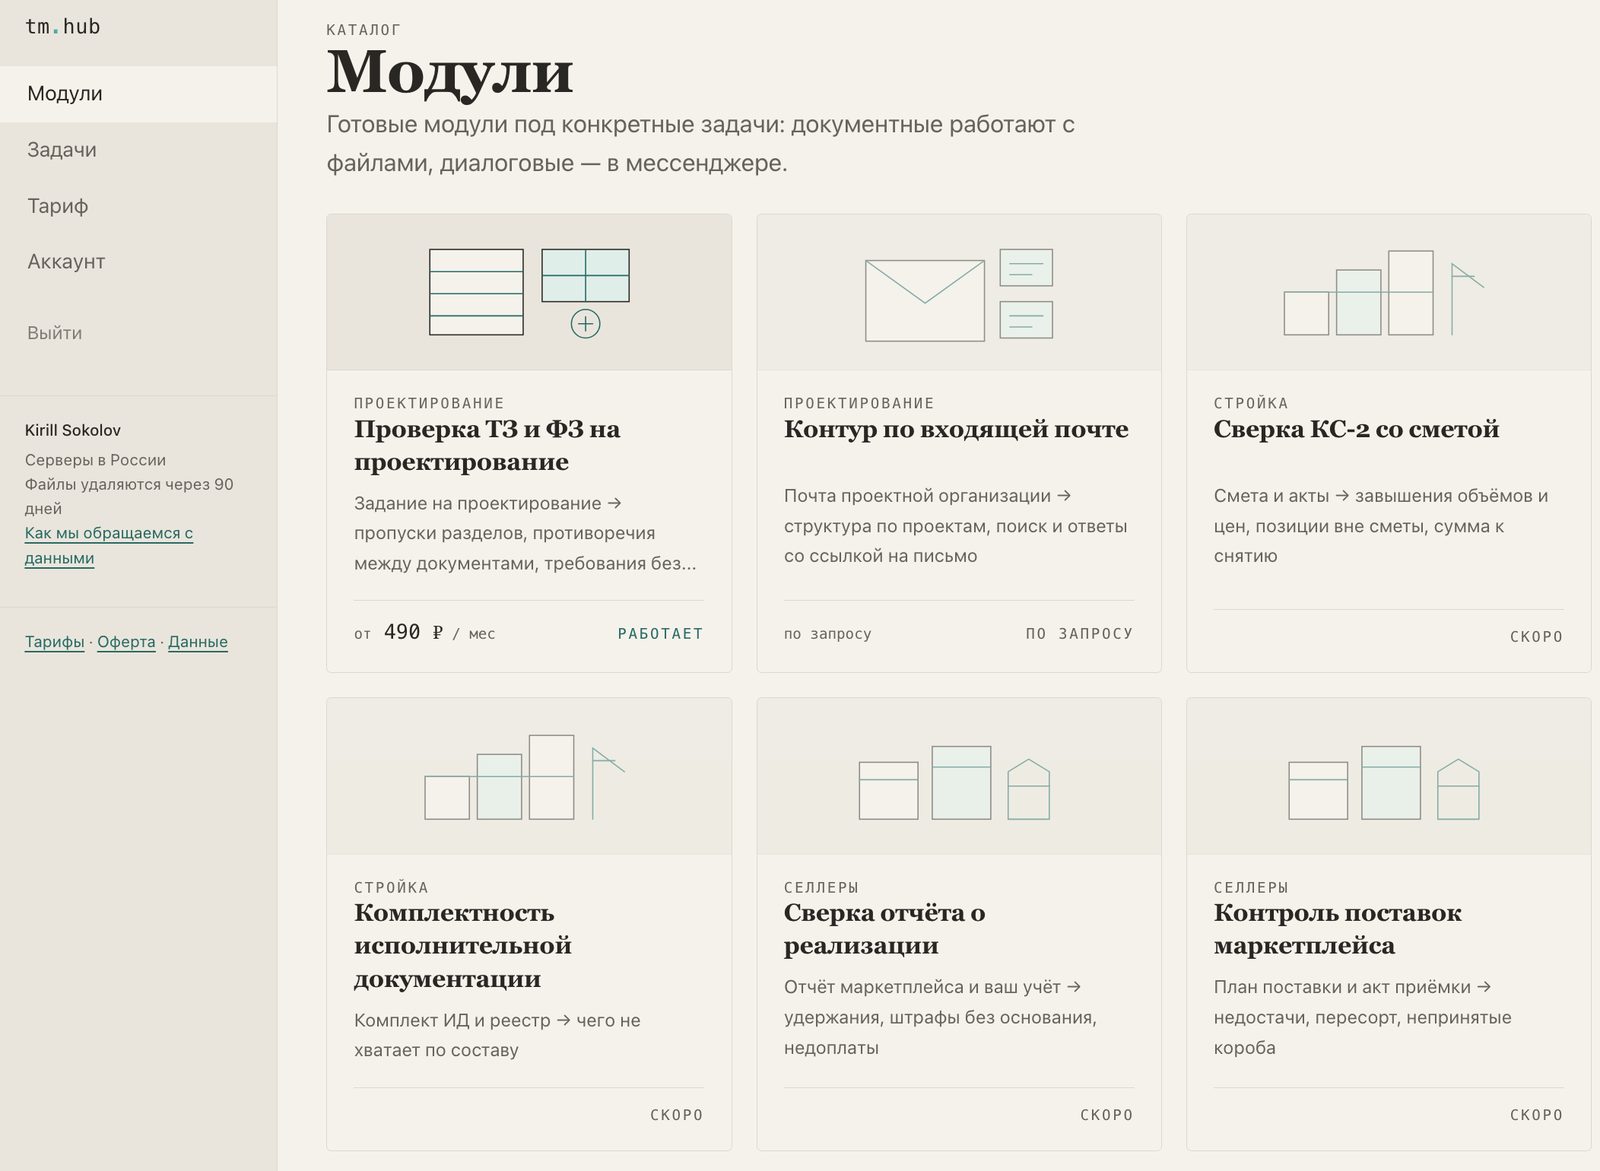
Каталог модулей
Каждый модуль — своя задача и свой набор правил. Документные работают с файлами, диалоговые — в мессенджере.
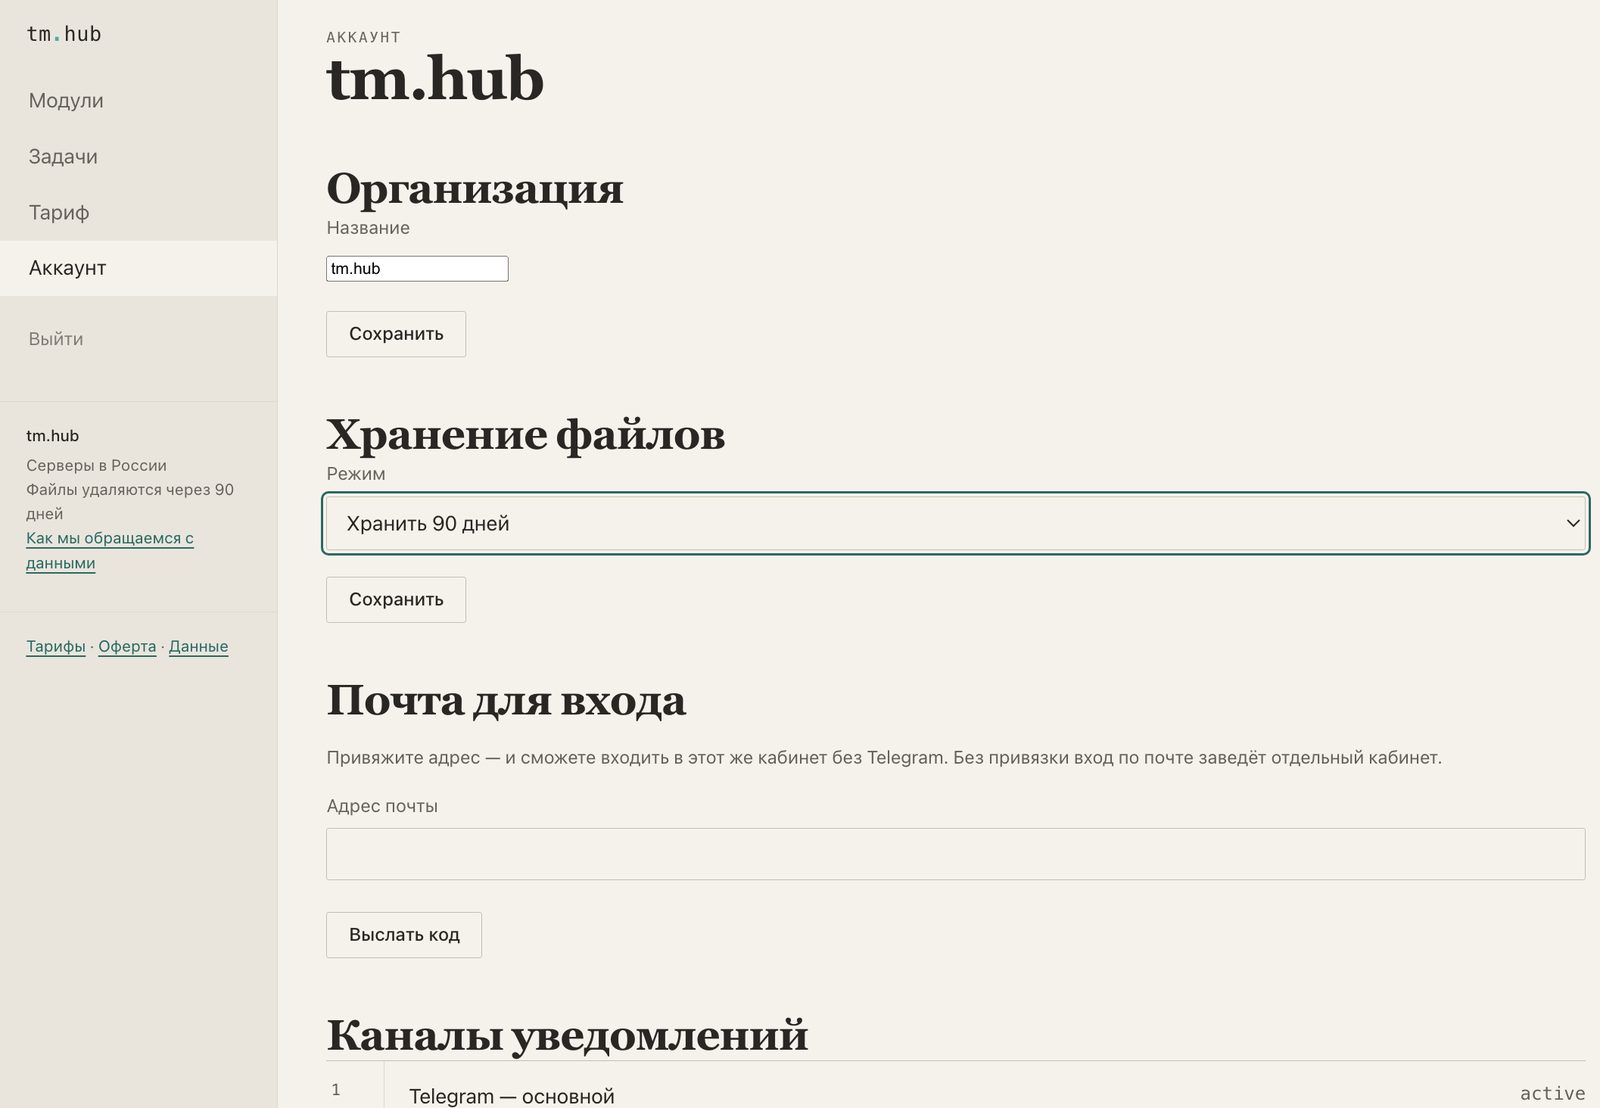
Хранение файлов
Режим хранения выбирает клиент — вплоть до удаления сразу после отчёта. Обещание вынесено в интерфейс, а не спрятано в оферту.
Моя роль
Спроектировал и собрал платформу целиком: архитектуру слоёв, документный движок, контракт модуля, личный кабинет, изоляцию данных на уровне базы, инфраструктуру и развёртывание.
Отдельно — доменную часть первого модуля: правила проверки задания на проектирование, включая те, что видны только при сопоставлении двух документов между собой.
Стек
- Приложение
- Python
- FastAPI
- Jinja
- HTMX
- Данные
- PostgreSQL
- Row Level Security
- Redis
- Движок
- openpyxl
- python-docx
- очередь задач
- Инфраструктура
- Docker Compose
- Traefik
- self-hosted
Текущий статус
Платформа работает в продакшене: личный кабинет, вход через Telegram, изоляция данных, тарифы и приём платежей, наблюдаемость с алертами.
Первый модуль проверен на настоящем комплекте — техническом задании и функциональном задании на проектирование центра обработки данных. Из 54 разобранных строк требований он нашёл 17 замечаний, шесть критичных: пропущенные разделы проектной документации и противоречия между двумя документами, которые при чтении каждого по отдельности не видны. Все находки получены детерминированно, без обращений к языковой модели.
Результаты
54
строки требований разобраны из двух документов
17
замечаний найдено, 6 из них критичные
0
обращений к языковой модели за проверку
Выводы
Разделение извлечения и решения оказалось важнее выбора модели. Как только правила стали считаться кодом, отчёт стал воспроизводимым — и его стало можно предъявлять, а не только читать.
Ограничение «данные клиента не уходят» задало архитектуру раньше, чем требования к функциям. Оно же оказалось главным аргументом в продаже, и хорошо, что было заложено с самого начала, а не добавлялось потом.
Совпадение по подстроке — плохая основа для правила: «раздел 7» находится внутри «подраздел 7». Каждое правило сверки между документами пришлось перевести на регулярные выражения, а порог качества считать по доле ложных срабатываний, а не на глаз.